


ChatGPT fora do ar: o que a quarta falha da OpenAI sinaliza
Publicado em 26 de julho de 2026.
Revisado em: 2026-07-26.
Detalhes sobre instabilidades mudam rápido. Antes de tomar decisões de trabalho, confira o estado mais recente na página oficial de status da OpenAI.
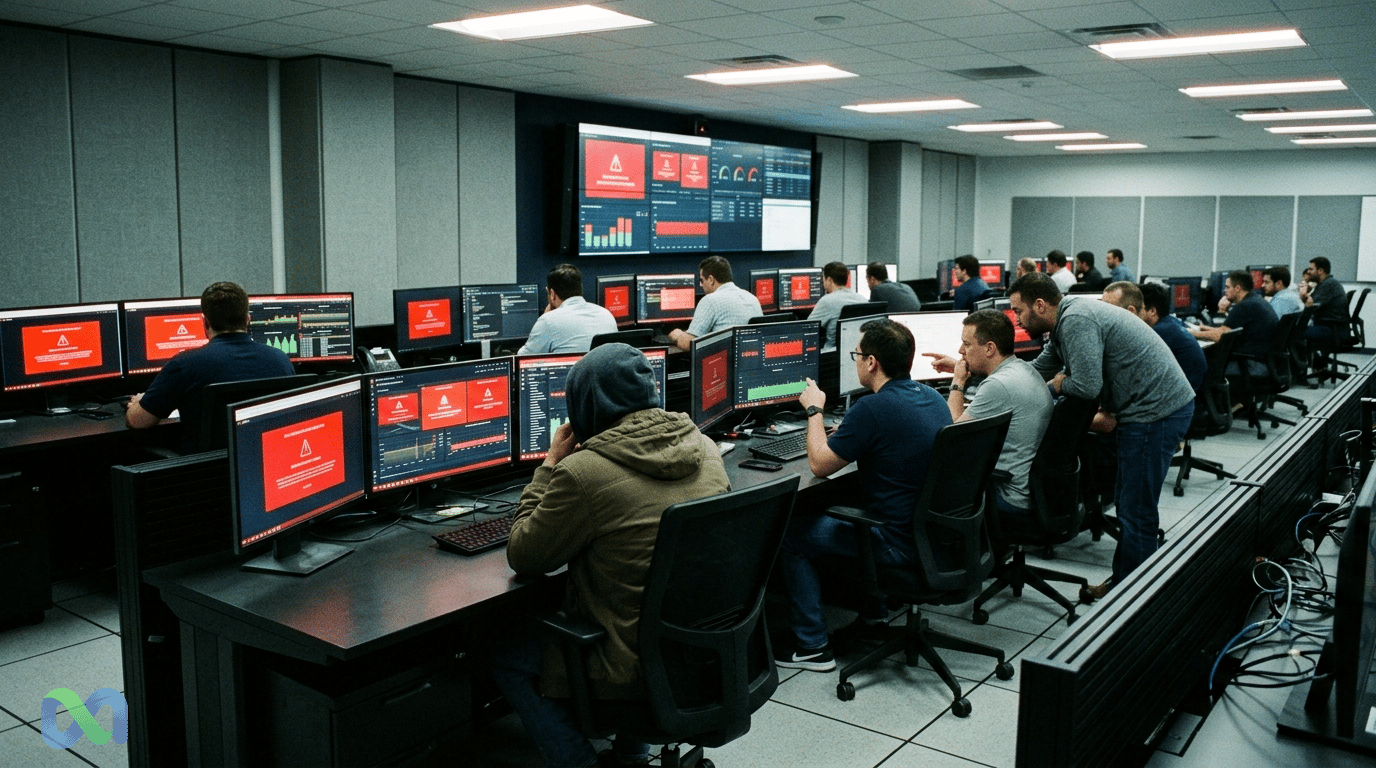
ChatGPT fora do ar já não é apenas um problema curto para usuários quando acontece várias vezes na mesma semana. Relatos de 25 de julho de 2026 descreveram outra interrupção em serviços da OpenAI, com impacto em ChatGPT, acesso à API e Codex. O episódio veio após uma sequência de falhas que colocou confiabilidade no centro da discussão.
A pergunta de busca é simples: o ChatGPT caiu? A pergunta de mercado é mais precisa: o que acontece quando uma ferramenta usada para redação, programação, suporte e análise interna começa a se comportar como infraestrutura crítica de trabalho?
Nossa leitura compara três tipos de fonte: atualizações de status da OpenAI, sites de relatos de usuários e cobertura da imprensa. Relatos citados sobre o Downdetector apontaram mais de 1.500 reclamações durante o incidente de 25 de julho.
A OpenAI se tornou uma camada padrão em muitos fluxos de trabalho. Por isso, interrupções devem ser lidas com cuidado. Um incidente isolado pode parecer rotina. Quatro falhas em quatro dias apontam para um risco mais amplo, que empresas precisam medir, planejar e incorporar nas decisões de adoção.
O que aconteceu no último caso de ChatGPT fora do ar
O último caso reportado de ChatGPT fora do ar teve como centro um aumento de erros nos serviços da OpenAI. Reportagens disseram que a empresa reconheceu problemas que afetavam APIs, ChatGPT e Codex. Ao mesmo tempo, sites de relatos de usuários mostraram um salto visível nas reclamações.
Essa combinação importa. A página oficial de status mostra a visão do provedor sobre o incidente. Plataformas de relatos mostram a experiência do usuário. Esses dois sinais podem divergir porque uma falha pode atingir regiões, contas ou serviços de forma desigual.
Na prática, usuários viram os sintomas que costumam impulsionar buscas por instabilidade. O ChatGPT não carregava, respostas travavam, prompts voltavam com erro ou chamadas de API ficavam pouco confiáveis. Para usuários individuais, isso significa perda de tempo. Para equipes, pode interromper filas de suporte, tarefas de software e rotinas de pesquisa.
O ChatGPT está fora do ar agora?
A única resposta segura precisa ter horário. Segundo reportagens de 25 de julho de 2026, a OpenAI enfrentou problemas de serviço e depois trabalhou na restauração. Para verificar o estado atual, use primeiro a página de status da OpenAI e compare com relatos de usuários em serviços como Downdetector.
Linha do tempo do incidente
- Atualizações de status da OpenAI: relatos citaram erros elevados nos serviços da empresa. Essa é a fonte oficial para confirmação do incidente.
- Relatos de usuários: o Downdetector mostrou alta nas reclamações sobre a OpenAI. Esse dado mostra como a interrupção foi sentida na ponta.
- Cobertura da imprensa: Sopa Cultural, Yahoo Finance UK e veículos indianos cobriram a falha. Isso mostra que a história passou de usuários isolados para notícia global.
- Sequência de quatro dias: reportagens enquadraram o caso como a quarta interrupção em quatro dias. Isso transforma um problema de suporte em uma discussão de confiabilidade.
Essa linha do tempo não deve ser lida como relatório completo de causa-raiz. Sem notas detalhadas da OpenAI, a causa exata permanece fora da visão pública. Para contexto mais amplo, o Business Insider relatou uma interrupção parcial anterior do ChatGPT, mostrando como incidentes assim viram notícia de tecnologia rapidamente.
Por que quatro falhas em quatro dias importam
Uptime costuma ser comunicado como percentual. Isso pode esconder a dor real do trabalho. Um produto pode manter forte disponibilidade mensal e ainda causar dano relevante se falhas se concentrarem durante horários úteis ou atingirem fluxos de alto valor.
Esse é o problema de quedas repetidas em ferramentas de IA. O custo não é só o tempo fora do ar. O custo é a dúvida. Equipes começam a perguntar se um prompt vai terminar, se uma execução de agente vai falhar e se um processo automatizado precisa de alternativa manual.
Para consumidores, ChatGPT fora do ar pode significar esperar algumas horas. Para empresas, pode significar revisão de código parada, rascunhos atrasados, suporte mais lento e prazos internos perdidos. Quanto mais uma equipe coloca IA no trabalho diário, mais cada interrupção se acumula.
É por isso que relatos de usuários também importam. Sistemas oficiais medem a saúde do serviço pelo lado do provedor. Usuários medem se o trabalho saiu. Quando essas leituras divergem, gestores precisam entender as duas.
Percentuais de uptime versus experiência do usuário
Um número de uptime responde a uma pergunta: o serviço esteve amplamente disponível em certo período? Ele não responde se um fluxo essencial falhou no pior momento possível.
Uma equipe de software que usa Codex durante uma janela de release se importa com confiabilidade naquela janela. Uma equipe de suporte que usa ChatGPT para redigir respostas se importa com velocidade em horário de pico. Um analista que usa a API da OpenAI em pesquisa se importa com retries que preservem o fluxo.
É aqui que incidentes concentrados mudam o perfil de risco. Eles obrigam empresas a sair de “essa ferramenta funciona na maioria dos dias?” para “o que acontece quando ela não funciona em uma hora crítica?”.
Risco de negócio quando IA vira sistema central
Serviços da OpenAI já fazem parte da pilha de trabalho de muitos usuários. ChatGPT cuida de pesquisa e redação. A API alimenta aplicativos internos. Codex apoia tarefas de engenharia. Essa amplitude transforma disponibilidade em variável de negócio.
O risco principal é concentração. Se um fornecedor sustenta muitas camadas de trabalho, uma falha pode se espalhar por várias funções ao mesmo tempo. Marketing espera rascunhos. Engenharia espera assistência de código. Suporte espera geração de respostas. Operações espera automação interna.
Isso não significa que empresas devam abandonar ferramentas de IA. Significa que devem tratá-las como sistemas centrais. Sistemas centrais precisam de monitoramento, backups, termos de serviço e planos para modos degradados.
A pergunta prática não é se ChatGPT é útil. Ele é. A pergunta é mais simples: as equipes sabem o que fazer quando o ChatGPT não funciona hoje? Elas sabem o que fazer quando a latência da API sobe ou quando um agente para no meio da tarefa?
Planejamento de contingência para ChatGPT, API e Codex
Equipes que dependem da OpenAI podem reduzir risco com um plano operacional simples:
- Acompanhar a página oficial de status da OpenAI e não depender apenas de relatos em redes sociais.
- Definir quais fluxos podem pausar e quais precisam de alternativa imediata.
- Manter um segundo provedor de modelo ou processo manual para tarefas críticas.
- Adicionar lógica de retry e filas em fluxos baseados em API.
- Documentar o que funcionários devem fazer quando o ChatGPT estiver indisponível.
- Revisar o histórico de interrupções antes de comprar ou renovar ferramentas de IA.
O ponto não é reagir demais a cada incidente. O ponto é tornar confiabilidade de IA visível. Se uma ferramenta economiza dez horas em semanas normais, mas cria gargalo súbito durante falhas, essa troca deve ser medida.
Como checar se o ChatGPT caiu
A checagem mais rápida ainda é oficial. Acesse a página de status da OpenAI e revise incidentes atuais, avisos de desempenho degradado e histórico recente. Essa é a página que a própria OpenAI controla e atualiza.
Depois, compare com sites de relatos de usuários. Downdetector e serviços parecidos podem mostrar se reclamações estão subindo em um país ou região específica. Trate esses números como relatos de usuários, não como contagem oficial de indisponibilidade.
Se a página oficial não mostrar incidente, mas o ChatGPT ainda falhar, teste causas locais. Verifique sua conexão, recarregue o aplicativo, tente outro navegador, desative extensões e teste outra rede. Se muitos usuários relatam o mesmo problema ao mesmo tempo, a chance de ser algo local diminui.
Por que o ChatGPT ficou fora do ar?
A causa deve vir das notas de incidente da OpenAI. Sem isso, usuários devem evitar afirmações confiantes sobre servidores, lançamentos de modelos, picos de tráfego ou falhas de infraestrutura. Sintomas públicos mostram que um serviço está fraco ou indisponível. Eles não provam a causa-raiz.
Essa distinção importa para análise séria. Especulação pode circular mais rápido que atualizações oficiais, mas pode induzir equipes ao erro quando elas precisam decidir se pausam trabalho, trocam ferramenta ou esperam a recuperação.
O que observar agora
O primeiro sinal é frequência. Se interrupções voltarem a ser isoladas, o mercado pode tratá-las como dores normais de crescimento de uma plataforma de IA sob alta demanda. Se falhas continuarem concentradas, confiabilidade vira fator mais forte na adoção empresarial.
O segundo sinal é a qualidade das atualizações. Usuários corporativos precisam de linhas do tempo claras, serviços afetados e notas de correção. Um aviso vago de “problemas em andamento” pode bastar para consumidores, mas é fraco para empresas que constroem fluxos sobre APIs e agentes.
O terceiro sinal é diversificação de clientes. Interrupções repetidas podem empurrar equipes para estruturas multimodelo, ferramentas locais de contingência ou contratos com compromissos de serviço mais fortes. Esse movimento conversa com outros debates sobre modelos de IA da OpenAI e risco de fornecedor. Isso não destrói a posição da OpenAI, mas pode mudar comportamento de compra.
Para mercados, a lição é maior que um caso de ChatGPT fora do ar. Sistemas de IA estão virando parte da camada de produtividade. Conforme isso avança, incidentes de confiabilidade viram sinais de adoção. Eles afetam confiança, desenho de fluxo e a velocidade com que empresas passam de testes para dependência. Também elevam a importância de acompanhar infraestrutura de IA como indicador de capacidade operacional.
Como mercados devem ler o risco de uptime em IA
Risco de confiabilidade é difícil de precificar porque não aparece apenas em manchetes de receita. Ele aparece primeiro no comportamento. Empresas desaceleram compras. Times de engenharia adicionam camadas de roteamento. Jurídico pede termos de serviço mais fortes. Produto desenha backups em vez de assumir que um modelo estará sempre disponível.
Essa mudança importa para quem acompanha adoção de IA. A tese de crescimento da OpenAI e do mercado de IA depende de confiança diária. Se usuários tratam ferramentas de IA como ajudantes ocasionais, quedas curtas importam menos. Se tratam como sistemas centrais de trabalho, quedas curtas pesam mais.
Investidores e operadores devem acompanhar três indicadores. O primeiro é cadência de incidentes. Uma interrupção isolada pode ser ruído. Um agrupamento repetido pode mudar percepção. O segundo é a área afetada. Uma falha que atinge ChatGPT, APIs e Codex tem mais significado operacional que um bug restrito ao aplicativo de consumo.
O terceiro indicador é a resposta dos clientes. Se empresas continuam usando um único provedor após falhas, a confiança permanece intacta. Se adicionam backups, renegociam termos ou adiam automações, confiabilidade virou questão comercial.
É aqui que o raciocínio de mercados de previsão ajuda. A pergunta não é “OpenAI é boa ou ruim?”. A pergunta melhor é sobre probabilidades. Quanto cada incidente altera a chance de grandes empresas colocarem trabalho em um único fornecedor de IA?
A resposta varia por cliente. Uma equipe de mídia pode tolerar alguns atrasos. Uma plataforma de suporte baseada em chamadas de API talvez não tolere. Uma empresa de software que usa ferramentas de programação agentiva em janelas de release pode exigir padrão mais rígido. Cada caso converte a mesma falha em prêmio de risco diferente.
O que empresas devem medir internamente
Equipes não precisam de um framework complexo para começar. Elas precisam de um registro simples de incidentes ligado ao trabalho real. Registre quando ChatGPT ou API da OpenAI falha, quais equipes são afetadas, quanto tempo a alternativa leva e se alguma entrega para cliente atrasou.
Esse dado interno é mais útil que um número genérico de uptime. Ele mostra se ferramentas de IA estão criando pontos fracos ou apenas adicionando velocidade opcional. Também ajuda áreas de compra a fazer perguntas melhores antes de fechar contratos maiores.
Um placar básico pode incluir cinco campos:
- O serviço afetado, como ChatGPT, acesso à API ou Codex.
- O fluxo afetado, como suporte, pesquisa, programação ou conteúdo.
- A duração da interrupção para a equipe.
- A alternativa usada e se ela funcionou.
- O impacto de negócio, incluindo atrasos, retrabalho ou prazos perdidos.
Com o tempo, isso dá aos gestores uma visão real de dependência. Se falhas não criam gargalo mensurável, o risco é modesto. Se falhas bloqueiam fluxos de alto valor repetidamente, a equipe deve investir em redundância.
Isso também protege a adoção de IA contra reações exageradas. Sem dados, uma queda barulhenta pode tornar líderes cautelosos demais. Com dados, eles separam incômodo de risco operacional. Essa disciplina é útil quando o mercado discute se modelos de IA fora de controle são sinal técnico relevante ou apenas ruído narrativo.
O mesmo registro pode alimentar conversas com o board. Em vez de dizer “a IA caiu de novo”, equipes podem mostrar quantas horas foram afetadas. Podem mostrar quais fluxos pararam e qual foi o custo da alternativa. Isso transforma uma reclamação vaga de tecnologia em métrica de trabalho. Também ajuda líderes a decidir se precisam de outro fornecedor, contrato mais forte ou processo melhor. Registros claros tornam a próxima falha mais administrável.
Conclusão
A quarta interrupção reportada da OpenAI em quatro dias transformou uma pergunta familiar em algo maior. Usuários ainda precisam saber se o ChatGPT caiu. Empresas precisam saber quão expostas ficam quando isso acontece. Um caso de ChatGPT fora do ar deve ser registrado, medido e revisado como qualquer outro risco de trabalho.
A resposta não é pânico. É disciplina. Acompanhe atualizações oficiais. Separe fatos confirmados de relatos de usuários. Construa fluxos de contingência antes da próxima queda. Depois, trate confiabilidade de IA como insumo claro no planejamento de tecnologia, não como surpresa cada vez que um prompt falha.
Esse hábito vai importar mais conforme ferramentas de IA entram mais fundo no trabalho diário.
