


Teorema de Bayes: como atualizar uma previsão com novas evidências
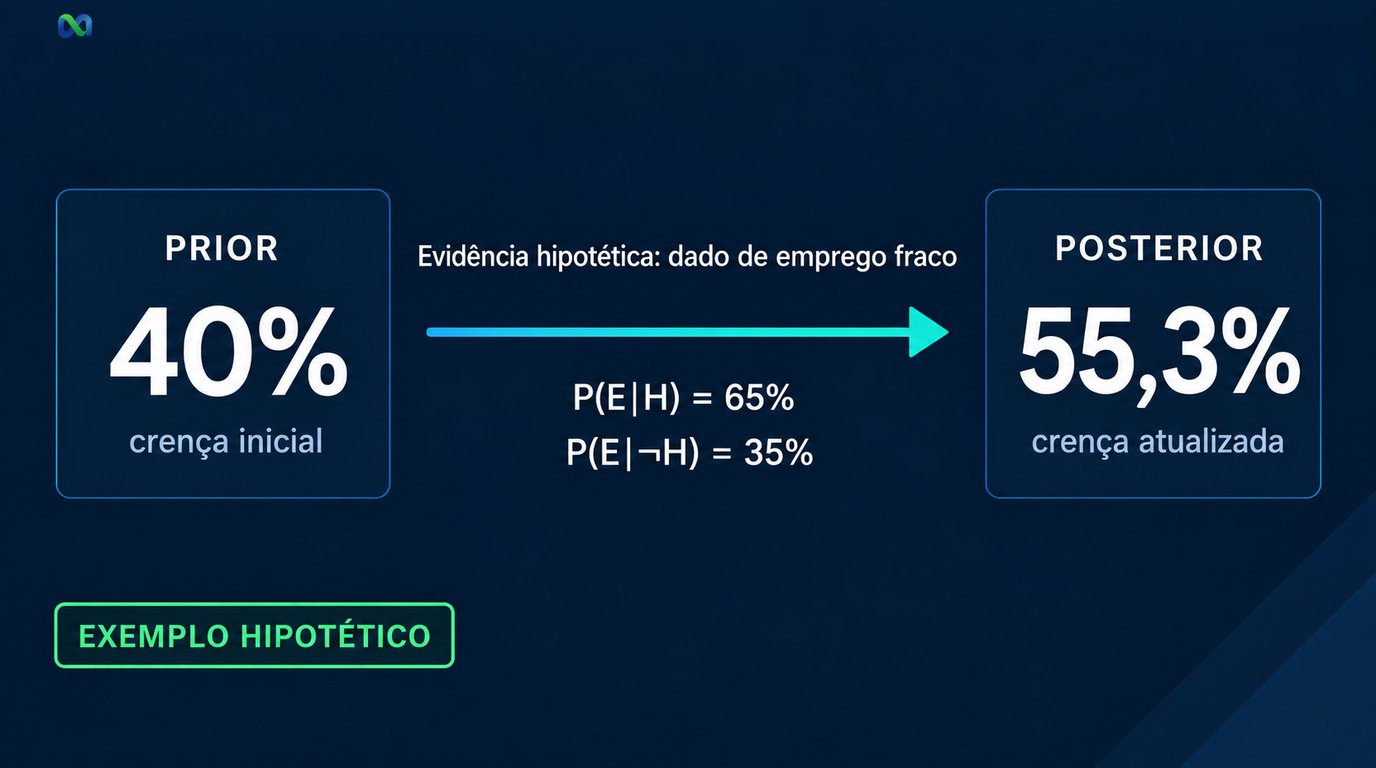
Exemplo hipotético: você começa com uma estimativa de 40% para um corte de 0,5 ponto percentual na Selic. Depois, observa um dado de emprego fraco. Como revisar a estimativa?
Todos os números deste guia são assumidos para ensinar o cálculo. Não são dados históricos do Banco Central, probabilidades observadas nem recomendação de operação.
O Teorema de Bayes ajuda a revisar uma estimativa quando chega um novo dado. Ele não cria uma chance do zero: usa uma chance inicial e um modelo da evidência. Se essas entradas forem ruins, a conta também pode levar a uma estimativa ruim.
Neste guia, você verá duas revisões em sequência. A segunda leva em conta o dado da primeira. Depois, verá por que uma chance inicial baixa pode subir bastante, sem se tornar certeza.
O que é o Teorema de Bayes?
O Teorema de Bayes é uma fórmula para rever a chance de um evento após um novo dado. Para usá-la, você precisa definir um modelo coerente. Nesse modelo, a evidência deve ter chance maior que zero.
Você começa com a prior, a chance inicial. Usa o likelihood P(E|H), explicado adiante, para chegar à posterior, a chance revisada.
A ideia é rever uma chance com base em novos dados. Bayes usa a probabilidade condicional. Ele calcula P(A|B) a partir de P(B|A), da chance inicial e da chance total da evidência.
A fórmula
A fórmula clássica é:
P(A|B) = P(B|A) × P(A) / P(B), com P(B) > 0.
Onde:
- P(A) = prior: a chance de A antes de ver B.
- P(B|A) = likelihood: a chance de ver B se A for verdadeiro.
- P(B) = chance total de B, calculada pela lei da probabilidade total.
- P(A|B) = posterior: a chance de A após ver B.
P(B|A) e P(A|B) não são a mesma coisa. A ordem importa: uma pergunta parte de A; a outra, de B. Para H e ¬H, que significam hipótese e seu oposto, a chance total da evidência é P(E) = P(E|H) × P(H) + P(E|¬H) × P(¬H). Como P(E)>0, a divisão dá a chance revisada entre 0 e 1.
Veja a regra do produto, a lei da probabilidade total e Bayes no material de probabilidade do IME-USP.
Prior, likelihood e posterior, os três pilares
Antes de calcular qualquer coisa, é preciso entender o que cada componente representa.
Prior é a chance que você atribui a H antes do novo dado. Ela pode vir de casos passados, de um modelo ou de uma estimativa com base clara. Essa escolha afeta o resultado.
Likelihood é P(E|H): a chance de ver o dado E se H for verdadeira. Compare com P(E|¬H), a chance de ver E se H for falsa. Se ambos forem iguais, E não muda a prior. A razão entre eles é a razão de likelihood, ou LR. Ela mede quanto E distingue H de ¬H.
Posterior é a chance revisada após E. Para a mesma hipótese, ela pode virar a prior da próxima etapa. Mas o novo cálculo precisa levar em conta o que você já sabe. Não conte o mesmo dado duas vezes.
Escolhendo a prior
A conta não corrige uma prior sem base. Um novo dado pode mudar muito o resultado, como no exemplo de taxa-base adiante. Mas você ainda precisa justificar as entradas do modelo.
Uma entrada possível é a taxa-base, ou base rate. Ela mede quanto um evento ocorreu em casos passados. Esses casos precisam ser comparáveis ao evento atual. Antes do novo dado, pergunte: quantas vezes isso ocorreu em casos parecidos?
Em mercados de previsão, possíveis entradas de um modelo incluem:
- Preços do mercado em eventos parecidos.
- Resultados de pesquisas e de modelos externos.
- Visões de analistas com conhecimento do tema.
- Chances implícitas em outros mercados relacionados.
Anote de onde veio a prior e quais dados ela já inclui. Se ela parte de um preço de mercado, uma notícia pode já estar nesse preço. Não a trate de novo como um sinal extra. Uma conta certa não prova que a prior tem boa base.
Como obter likelihoods sem inventá-los
O preço não fornece P(E|H) e P(E|¬H). Você precisa de um modelo, dados de casos parecidos ou premissas claras. Defina o que é E. Confira como E foi medido nos casos H e ¬H. Esses dados já levam em conta o histórico conhecido?
Sem esses valores, não há posterior numérica a calcular. Uma notícia favorável não basta para somar pontos à prior. Neste guia, os likelihoods são premissas de ensino. Não são dados medidos.
Exemplo passo a passo
Vamos usar um exercício sobre juros. Todos os números são hipotéticos e servem só para ensinar. Não são dados históricos do Banco Central nem cotações de um mercado real.
Cenário hipotético: vamos assumir 40% de chance de o Copom cortar a Selic em 0,5 ponto percentual na próxima reunião. Essa é a prior do exercício, não a leitura de uma cotação real. Usar preços de futuros como prior exige um modelo próprio. Não é uma leitura direta de probabilidade implícita.
Prior (assumida): P(H = corte) = 0,40
Sai um dado de emprego mais fraco do que o esperado. Assumimos os seguintes likelihoods hipotéticos:
Likelihood (assumido):
- P(dado fraco | H = corte acontece) = 0,65
- P(dado fraco | ¬H = corte não acontece) = 0,35
Passo 1: calcular P(dado fraco)
Usando o teorema da probabilidade total:
P(dado fraco) = P(dado fraco | corte) × P(corte) + P(dado fraco | ¬corte) × P(¬corte)
P(dado fraco) = 0,65 × 0,40 + 0,35 × 0,60 = 0,26 + 0,21 = 0,47
Passo 2: calcular a posterior
P(corte | dado fraco) = (0,65 × 0,40) / 0,47 = 0,26 / 0,47 = 26/47 ≈ 55,3%
A chance passou de 40% para 55,3%. Nas premissas do exercício, o dado fraco é mais provável quando há corte. Por isso, a chance de corte subiu. Isso não prova que as premissas descrevem o mundo real.
O Seeing Theory, da Brown University, mostra de forma visual como prior e likelihood geram a posterior.
Atualização sequencial, quando chegam múltiplas evidências
Você pode rever a chance à medida que chegam novos dados. Não precisa esperar todos eles. A conta seguinte parte do que foi aprendido na etapa anterior.
O processo é direto:
- Prior inicial → aplica evidência 1 → posterior₁
- Posterior₁ vira a nova prior → aplica evidência 2 → posterior₂
- Repete conforme chegam novas evidências
Continuando o cenário hipotético do COPOM:
Nova prior (exata): P(H|E1) = 26/47, P(¬H|E1) = 21/47
Use a fração exata 26/47. Guarde 55,3% só para exibir o valor. Assim, o arredondamento não afeta a conta seguinte.
No exercício, surge o segundo dado: uma fala com tom hawkish. Aqui, isso significa maior preocupação com a inflação.
Likelihood para E2 (assumido com independência condicional dado H e dado ¬H):
Para simplificar o exercício, assumimos P(E2|H, E1) = P(E2|H) e P(E2|¬H, E1) = P(E2|¬H). Ou seja: fixado H ou ¬H, E1 não muda a chance de E2. Isso se chama independência condicional. Bayes não exige essa hipótese. Sem ela, use as chances de E2 que já levam E1 em conta.
- P(E2 = hawkish | H = corte, E1) = 0,25
- P(E2 = hawkish | ¬H = sem corte, E1) = 0,70
Denominador correto: P(E2|E1), não P(E2) incondicional
Na segunda etapa, você já conhece E1. Portanto, o denominador é a chance de E2 dado E1. Usar P(E2) sem essa condição pode mudar o resultado para cima ou para baixo. A direção depende do modelo.
P(E2 | E1) = P(E2|H, E1) × P(H|E1) + P(E2|¬H, E1) × P(¬H|E1)
P(E2 | E1) = 0,25 × (26/47) + 0,70 × (21/47) = (6,5 + 14,7) / 47 = 21,2/47
Posterior₂ (valores hipotéticos):
P(H | E1, E2) = [P(E2|H, E1) × P(H|E1)] / P(E2|E1) = (0,25 × 26/47) / (21,2/47) = 6,5 / 21,2 = 65/212 ≈ 30,7%
| Momento | Evento | P(corte) |
|---|---|---|
| Início | Prior assumida | 40,0% |
| Após dado de emprego fraco | Evidência 1 | 55,3% |
| Após declaração hawkish | Evidência 2 | 30,7% |
Todos os valores são hipotéticos. Tabela ilustra o encadeamento, não probabilidades observadas.
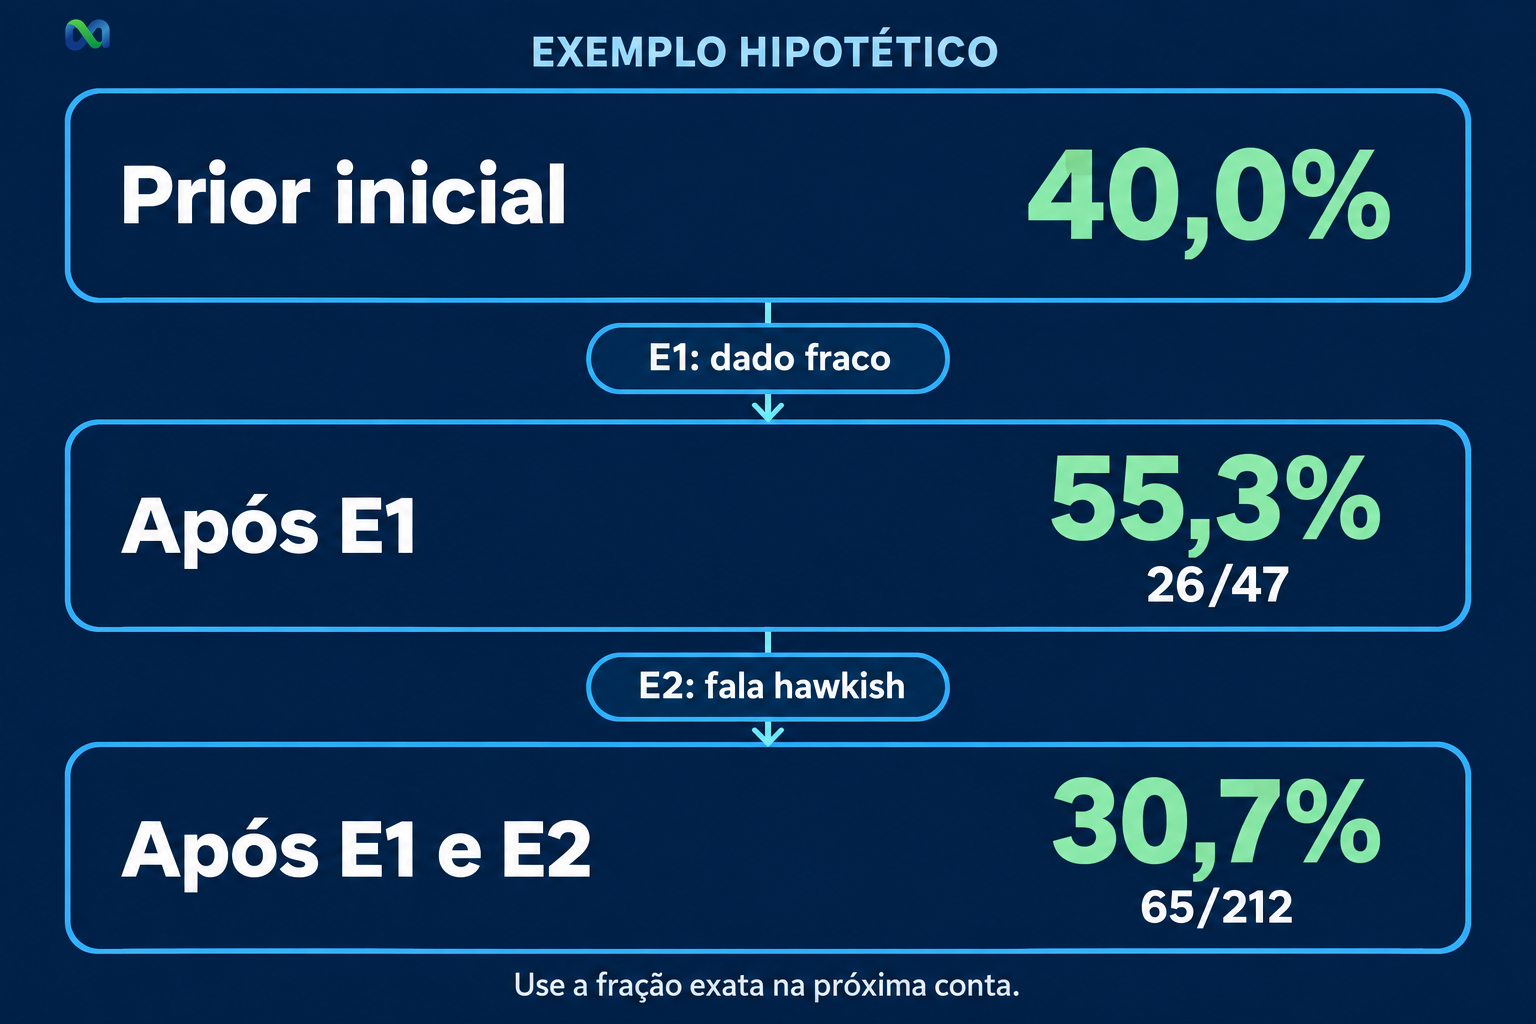
Neste exercício, a declaração com tom hawkish reduziu a estimativa de 55,3% para 30,7%, abaixo da prior original de 40%.
Não conte duas vezes o mesmo dado. Duas notícias podem apenas repetir E1. Verifique se E1 afeta a chance de E2 quando H é fixado, e também quando ¬H é fixado. Não basta olhar a correlação entre as notícias. Trocar P(E2|H, E1) por P(E2|H) sem base pode distorcer a conta.
Se E2 for uma cópia exata de E1, nada de novo foi aprendido. Nesse caso, P(E2|H, E1)=P(E2|¬H, E1)=1, para hipóteses ainda possíveis. A posterior não muda. Tratar a cópia como um sinal independente mudaria a conta sem novo dado.
Para traduzir probabilidades revisadas em decisões de posição, consulte o artigo sobre valor esperado.
Por que a taxa-base importa
Ignorar a taxa-base é concluir que H é provável apenas porque E seria frequente se H fosse verdadeiro. Falta comparar com o cenário alternativo e com a prior. A aula de Stanford STATS60 sobre erros de probabilidade condicional explica essa diferença.
O ponto aqui é o cálculo: P(E|H) alto não implica, sozinho, P(H|E) alto.
Quando 0<p<1, a posterior passa de 50% se LR>(1−p)/p. Com prior de 5%, esse limite é 19. Logo, o dado precisa ser mais de 19 vezes tão provável sob H quanto sob ¬H.
Exemplo hipotético: prior P(H) = 5%, P(E|H) = 0,80 e P(E|¬H) = 0,04. A razão de likelihood LR = 0,80/0,04 = 20 e P(E) = 0,80 × 0,05 + 0,04 × 0,95 = 0,078. Usando odds bayesianas:
- Prior odds = 5/95 = 1/19
- Posterior odds = (1/19) × 20 = 20/19
- Posterior P(H|E) = (20/19) / (1 + 20/19) = 20/39 ≈ 51,3%
Neste exercício, E é 20 vezes tão provável sob H quanto sob ¬H. Assim, a chance inicial de 5% chega a 51,3%. Uma prior baixa pode subir bastante. Mas uma notícia chamativa não prova que sua LR é alta.
Antes da conta, revise a base da prior. Os casos usados são parecidos com o evento atual? Essa checagem não elimina vieses. Também não dispensa a avaliação dos likelihoods.
Para medir a qualidade das suas previsões bayesianas ao longo do tempo, consulte o artigo sobre calibração e Brier Score.
Limites do Teorema de Bayes em mercados de previsão
A chance calculada por você não é o preço de execução de um contrato. Bayes não define como uma plataforma recebe ordens ou calcula cotações. Isso depende do produto e de suas regras. Este exercício não descreve a arquitetura da Macro Markets.
Bayes ajuda a rever previsões. Não garante acerto: a conta pode estar certa e a estimativa, ruim. Isso ocorre se a prior ou os likelihoods não descrevem bem o evento.
Leve a dependência em conta. Se duas evidências usam o mesmo dado, confira P(E2|H, E1) e P(E2|¬H, E1). Não assuma que E1 não importa. A regra do produto permite usar essas chances sem exigir independência.
Uma analogia precisa ter base. Dizer "parece 2018" não basta para definir a prior. Compare os casos, anote suas diferenças e os limites do modelo.
Perguntas frequentes
Para que serve o Teorema de Bayes?
Serve para rever a chance de um evento após um novo dado. Neste guia, ele ajuda a revisar uma previsão sobre juros. Você precisa de uma prior e de um modelo da evidência; a fórmula não fornece essas entradas.
Qual é a fórmula do Teorema de Bayes?
P(A|B) = P(B|A) × P(A) / P(B), com P(B)>0. P(A) é a prior, P(B|A) é a probabilidade de observar B dado A, P(B) é a probabilidade total da evidência e P(A|B) é a posterior.
Qual a diferença entre Bayes e Naive Bayes?
Bayes não exige independência entre todas as evidências. O classificador Naive Bayes adota uma simplificação: as características são condicionalmente independentes dada a classe. Não é independência geral entre elas. A introdução de Chris Piech ao Naive Bayes (Stanford) detalha essa hipótese: as características são independentes umas das outras dado o rótulo de classe, não em geral.
Resumo do Teorema de Bayes
Bayes não elimina a dúvida. Ele torna explícitos os dados e as premissas usados para rever uma chance.
Comece com uma prior bem justificada. Avalie P(E|H) e P(E|¬H), depois calcule a posterior. Na próxima etapa, use essa posterior como prior e leve o histórico em conta. Guarde 26/47, não 0,553, para a próxima conta.
Não ignore a prior nem conte duas vezes a mesma informação. O denominador correto na atualização sequencial é P(E2|E1), não P(E2), e a distinção importa.
Em mercados de previsão, Bayes não substitui o conhecimento do tema. Ele ajuda a organizar premissas num modelo que você pode rever e testar com o tempo.
Este guia é educativo. As contas não comprovam probabilidades reais, autorização de uma plataforma ou oportunidade de investimento.
Fontes consultadas
- Brown University, Seeing Theory: prior, likelihood e atualização para posterior; material educativo arquivado.
- IME-USP, Probabilidade condicional: regra do produto, probabilidade total e Bayes.
- Stanford STATS60, Erros em probabilidade condicional: distinção entre condicionais e taxa-base.
- Chris Piech / Stanford, Naive Bayes: independência condicional das características dada a classe.
Fontes consultadas em 8 de outubro de 2026. Os exemplos de Selic e de razão de likelihood são exercícios próprios hipotéticos, não dados fornecidos por essas instituições.
